
2026 年 4 月 23 日,OpenAI 發布自 GPT-4.5 以來首次完整重訓的基礎模型 GPT-5.5,並在當天的官方資料中宣稱拿下 Terminal-Bench 2.0 第一名、得分 82.7%。一個月後再回看這個分數,會發現它的意義不在「OpenAI 又拿了一座榜首」,而在於它把 Agentic AI 的能力邊界推進到一個值得被命名的新階段,『自主修錯』。
這個小節點為什麼值得花時間理解?因為 Terminal-Bench 2.0 不是一個能用「背題庫」過關的測驗。它考的是「給 AI 一個目標、丟它進真實的命令列環境,讓它自己規劃、執行、驗證、修錯,直到任務完成」。Anthropic 的 Claude Opus 4.7(前榜首)在同一測驗拿下 69.4%,Google 的 Gemini 3.5 Flash 拿下 76.2%,阿里的 Qwen3.7 Max 拿下 69.7%——GPT-5.5 的領先幅度高達 13 個百分點,這不是「漸進式改善」的訊號。
對企業而言,這個數字真正關鍵的,不是「誰是第一」,而是「Agentic AI 的工程可行性,正在快速接近可被信任的水準」。理解這個拐點代表什麼,比追蹤下一次榜單變動更接近實際的經營題目。
一、Terminal-Bench 82.7%:為什麼這個分數值得被重視?
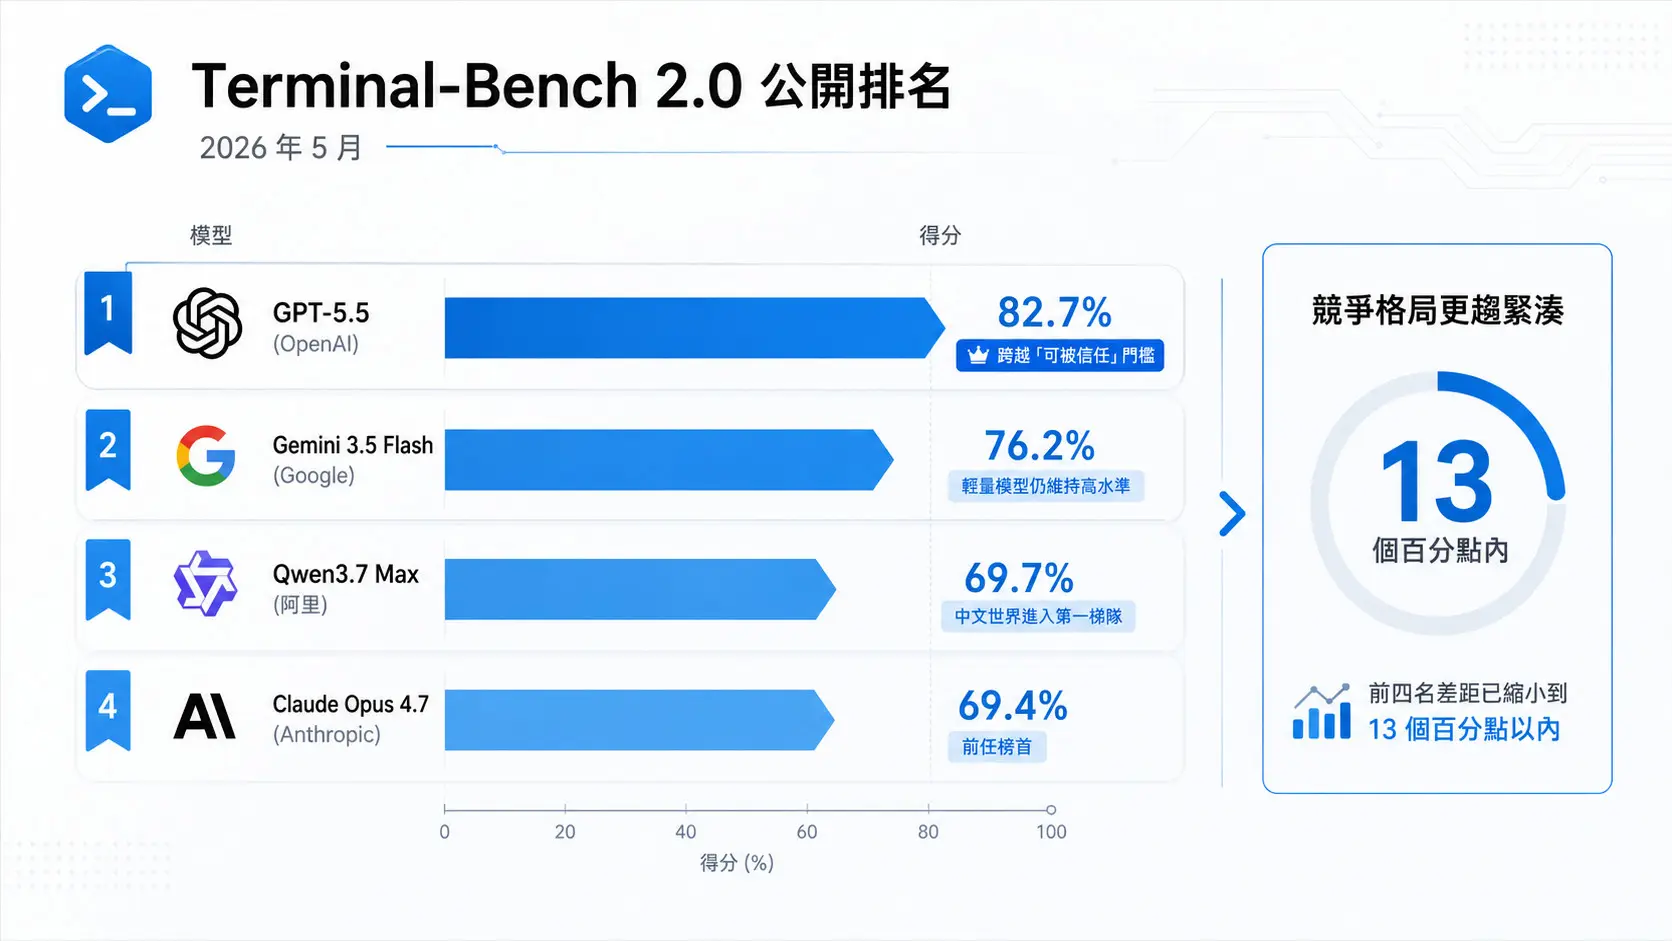
Terminal-Bench 2.0 由 Stanford、Anthropic、Snorkel AI 等單位共同開發,包含 89 項在真實命令列環境裡執行的任務。題目來自實際工程場景:編譯程式碼、訓練模型、設定伺服器、除錯系統、執行多步驟資料處理。每一題都需要模型自行規劃步驟、操作工具、判讀結果、自我修正。通過率不靠「答對選項」,而是看「任務最終有沒有完成」。
這個榜單的設計,刻意排除了傳統大模型擅長的「短回應、單一回合」題型,迫使模型展現完整的代理(agentic)能力。下表整理了 2026 年 5 月初的公開排名:
| 模型 | Terminal-Bench 2.0 | 觀察 |
| GPT-5.5(OpenAI) | 82.7% | 2026/4/23 發布即登榜首,跨越多數工程任務的「可被信任」門檻 |
| Gemini 3.5 Flash(Google) | 76.2% | 輕量級模型仍能維持高水準,反映模型小型化未必犧牲代理能力 |
| Qwen3.7 Max(阿里) | 69.7% | 中文世界模型逼近第一梯隊,差距已從「世代落後」縮為「個位數百分點」 |
| Claude Opus 4.7(Anthropic) | 69.4% | 前任榜首,仍被視為「程式碼可靠度」標竿;新版本可能於下個版本回擊 |
把這張表放在桌上,幾個觀察值得被討論。第一,前四名的差距已縮小到 13 個百分點以內,意味著「代理能力」不再是單一廠商的護城河;第二,第二名是 Google 的輕量模型(不是旗艦),代表「小模型 + 好的代理框架」可能比「大模型」更具有部署性價比;第三,中文世界模型的進入第一梯隊,對在地化部署是一個新的可能性。
二、「自主修錯」的工程意義:從生成式到代理式的轉折點
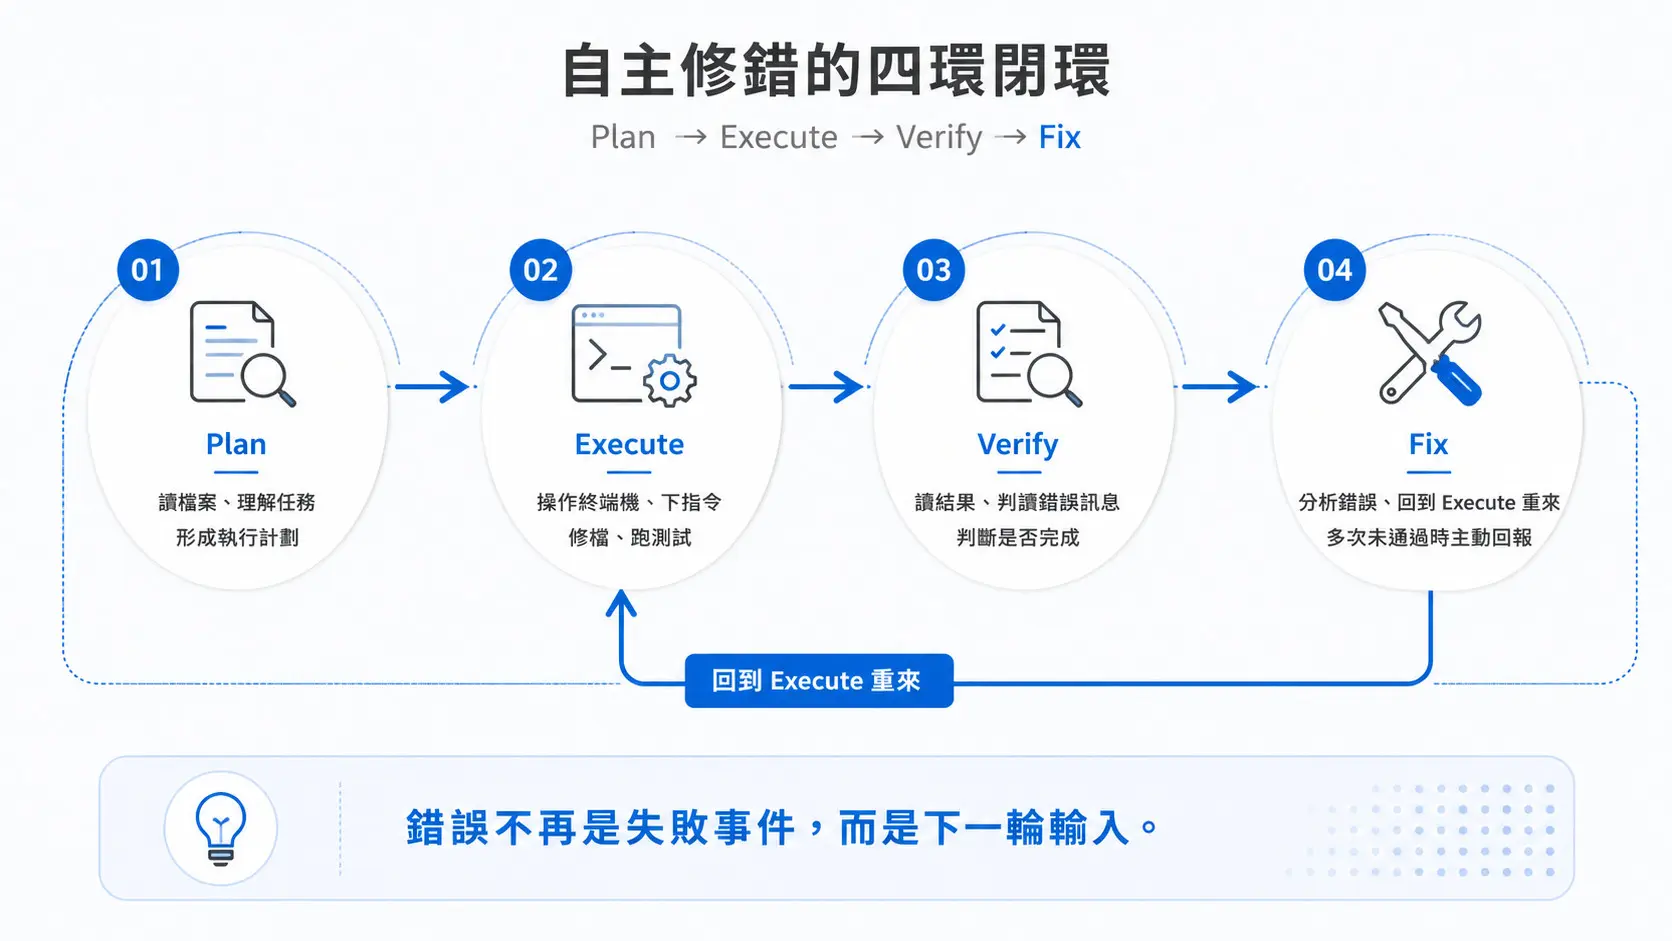
GPT-5.5 真正讓技術圈關注的,不是分數本身,而是它在公開資料中揭露的「閉環」設計,一個被多數研究者稱為 Plan → Execute → Verify → Fix 的循環。
循環的四個環節
- Plan(規劃):模型接到自然語言任務(例如「修好這份儲存庫裡的三個失敗測試」),先讀取相關檔案,形成執行計劃。
- Execute(執行):模型實際操作終端機,下達指令、修改檔案、執行測試。這一步驟過去高度依賴人工監督。
- Verify(驗證):模型讀取執行結果(測試輸出、錯誤訊息、編譯回報),判讀任務是否完成。
- Fix(修錯):若驗證未通過,模型分析錯誤、形成修正計劃,回到 Execute 重來一次;若多次嘗試仍未通過,會主動回報「無法完成」而不是給出虛假成功。
從產品語言看,這聽起來像「AI 寫了程式還會自己除錯」。但從工程角度看,這個循環真正的價值是兩件事:第一,把不確定性消化在模型內部,不必每一步都回頭問人;第二,把錯誤從「失敗事件」轉化為「下一輪輸入」,這是讓 AI 真的能「跑長任務」的關鍵設計。
為什麼這是「世代轉折」?
過去兩年大眾熟悉的 AI 工作流程,多數仍是「一問一答」。即使有思考鏈、外部工具、檢索增強等強化,本質仍是「模型回應一次、人類審查一次」。當模型能在沒有人介入的情況下,自己跑完十幾個動作的工程任務,並且在中途自己抓出錯誤、自己修正、自己驗證,這就跨越了一個關鍵門檻:從「需要人在環中(human-in-the-loop)」走向「人在環外監督(human-on-the-loop)」。
這個門檻在學術界爭論了多年,2026 年 4 月的這份榜單算是給出了一個可被引用的「數字證據」。對企業而言,這代表許多過去因為「AI 還不夠可靠」而暫緩的代理式應用,正在重新進入可評估的範圍。
核心觀察:Terminal-Bench 2.0 的 82.7% 不是線性進步,而是 Agentic AI 從「實驗室概念」進入「可被工程化部署」的訊號。其背後的 Plan → Execute → Verify → Fix 閉環,是這一輪變化的核心引擎。
三、對企業 AI 落地的 3 個觀察
當「自主修錯」從可能變成可驗證,企業在思考 AI 落地時,可關注的觀察面向也會跟著移動。下列三個面向不是行動清單,而是內部討論時可以納入考量的方向。
觀察一:可被代理化的工作流範圍正在擴大
過去十二個月,企業導入 AI 代理多半侷限在「對話式客服」與「文件摘要」這兩個低風險場景。當 Terminal-Bench 2.0 等真實環境測試開始有模型穩定超過 80%,代表「需要多步驟、需要工具、需要驗證」的工作流(例如:營運報表的端到端產生、IT 例行維運的自動化、資料管線的自我修復),正在進入可被評估的範圍。值得留意的是,這個擴大不是一夜發生,而是會隨著模型穩定性與工具生態成熟,逐步外擴。
觀察二:「人在環中」與「人在環外」的選擇變得重要
當代理能力突破某個門檻後,企業的決策不再是「要不要用 AI」,而是「在哪些流程上,人需要逐步審查(human-in-the-loop);在哪些流程上,人只需要設定邊界並監督結果(human-on-the-loop)」。前者保留最高的可控性,但會吃掉代理帶來的效率紅利;後者效率最高,但要求對任務邊界、風險閥值、回退機制有更清晰的設計。這條分線怎麼畫,會在未來十二個月成為企業 AI 治理的核心題目。
觀察三:模型選型不再只看單一榜單
過去兩年,企業常用 MMLU、HumanEval 等單點測驗作為模型選型依據。Terminal-Bench、GDPval、SWE-Bench Verified、Tau-Bench 等代理導向的基準,揭示了一個事實,不同任務型態適合不同模型。一個榜首未必在你的場景表現最好;一個非榜首模型可能在你的特定工作流(例如:資料處理、合約審閱、客服自動化)有更好的成本效益。建立「以場景測試決定選型」的內部流程,會逐步取代「跟著榜單買」的習慣。
結語:拐點過後,組織能力是更被低估的變數
把 GPT-5.5 的 82.7% 放在 Agentic AI 發展史的時間軸上看,這不是「一個分數的勝利」,而是「一個範式逐漸成熟」的訊號。代理能力跨過 80% 後,下一輪 AI 競賽的關鍵不再只是「模型誰最強」,而是三件事:
第一,誰能把代理能力與企業實際工作流接好。模型強只是起點,工作流接得通、權限切得對、回退機制設得好,才是真正落地的決定因素。
第二,誰能把組織重新設計到「人在環外」的工作模式。代理能跑長任務後,組織的角色定義、KPI 設計、責任邊界都需要重新校正。這個轉變的難度,遠高於導入單一工具。
第三,誰能把錯誤治理機制做得夠成熟。當 AI 能自我修錯,企業的稽核、合規、風險邊界都需要新的設計語言。「AI 沒做錯」與「AI 在可接受範圍內試錯後完成任務」不是同一件事,後者需要全新的治理框架。
對企業領導者而言,這份榜單的最值得留下的訊號不是 82.7% 這個數字,而是它揭示的時間表——「代理式 AI」不再是兩三年後的命題,而是接下來十二個月就會出現在許多採購討論桌上的選項。可關注的方向,是組織內部的「代理工作流盤點」與「人機協作邊界設計」這兩件事,是否已經在下一季的議程上。
本文觀察重點:GPT-5.5 在 Terminal-Bench 2.0 拿下 82.7%,揭示 Agentic AI 從「實驗室概念」進入「可被工程化部署」階段。Plan → Execute → Verify → Fix 自主修錯閉環是核心引擎;可被代理化的工作流範圍正在擴大;「人在環中 vs 人在環外」的設計、與「以場景測試決定選型」會成為新的選型語言。

如有任何問題或需求,請填寫以下表單,我們將竭誠為您解答!
您也可以透過以下按鈕了解更多資源: