
台灣時間 6 月 9 日,Anthropic 一口氣發布兩款新模型 Claude Fable 5 與 Claude Mythos 5,並宣布 Fable 5 即日起全面上線。官方為這次發布定下的關鍵字是「Mythos 級」。一個能力凌駕現有 Opus 之上、過去只在小範圍試行的最高一級模型;這次,它首度以「對一般使用者安全」的形式對外開放。
三個最受關注的重點:能力幾乎在所有測試基準上站上目前最前緣、定價只要前代 Mythos Preview 的一半不到、以及一套「偵測到敏感請求就自動降級回應」的全新安全機制。以下用四個層次,帶大家快速掌握這則發布的全貌。
一、先看定位:Anthropic 這次到底發布了什麼?
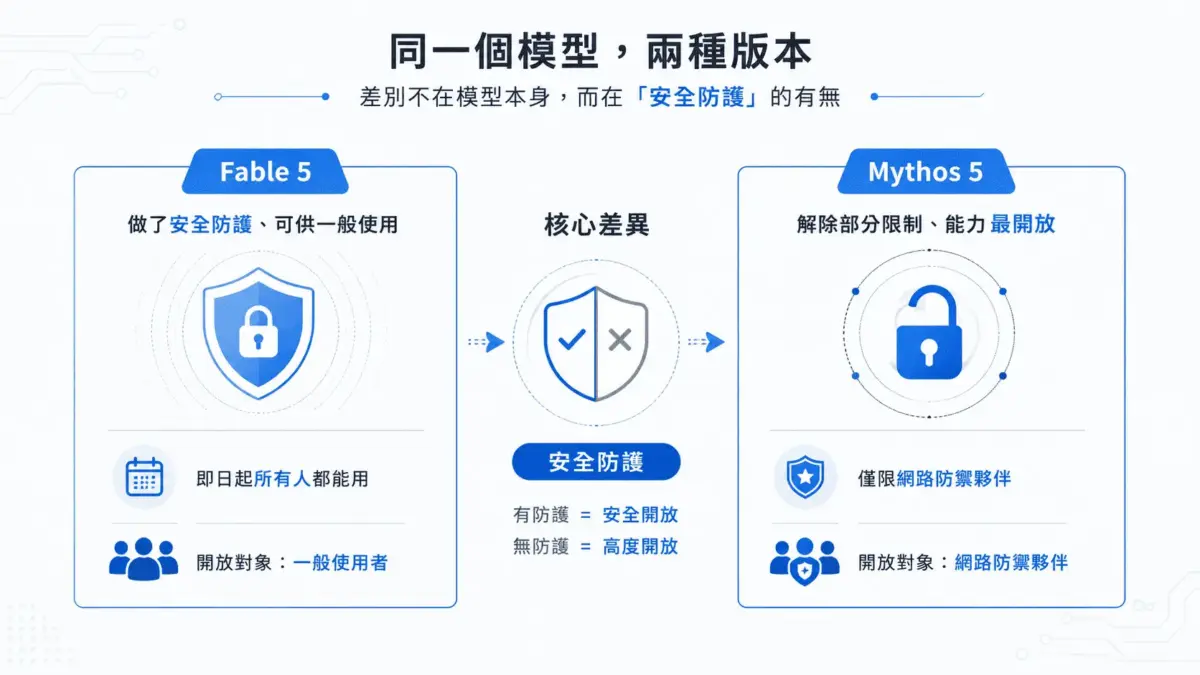
這次同時亮相的是「同一個底層模型、兩種版本」。Claude Fable 5 是把 Mythos 級能力「做了安全防護、可供一般使用」的版本,即日起所有人都能用到;Claude Mythos 5 則是解除部分安全限制的版本,目前只先開放給少數網路防禦與關鍵基礎設施夥伴,透過與美國政府合作的 Project Glasswing 部署,官方稱其網路安全能力是目前全世界最強。兩者差別不在模型本身,而在「安全防護」的有無。這也正是兩個名字的由來。
換句話說,這則新聞真正的轉折點是:過去因為風險太高、只敢給少數人試用的頂級能力,Anthropic 認為防護已經做到足以對外開放,於是把「閹割了危險用途、但保留全部一般能力」的 Fable 5 推給所有使用者。
二、能力亮點:任務越長,領先越大
官方這次反覆強調的一句話是:「任務越長、越複雜,Fable 5 領先其他模型的幅度就越大。」最具體的畫面來自早期測試夥伴 Stripe:在一套五千萬行的 Ruby 程式碼庫裡,Fable 5 用一天完成了一場全庫遷移。同樣的工作,一整個工程團隊徒手做要超過兩個月。它能在數百萬 token 的長任務中保持焦點,並用自己留下的筆記持續修正產出;在需要長線規劃的測試場景中,給它一份可持續存取的記憶,帶來的表現提升是前代模型的三倍。
而這份實力不只出現在寫程式一個領域。依官方揭露,Fable 5 在資深層級的財務推理評測上拿下最高分,在視覺任務上成為新標竿(能從截圖反推出一個網頁應用的原始碼、僅憑遊戲畫面就獨立通關一款電玩);搭載相同底層的 Mythos 5 則把蛋白質設計流程的部分環節加速約十倍,並首度能穩定產出讓科學家在盲測中約八成情況更偏好的新穎研究假說。
把這些放在一起看,值得留意的是衡量能力的單位正在改變。從「單題答對幾題」,變成「能不間斷地自主推進多久、跨多少個領域」。這條軸線,正是這次發布想凸顯的差距所在。
三、同步上線的安全機制:偵測到敏感請求,改「降級」而非「拒絕」
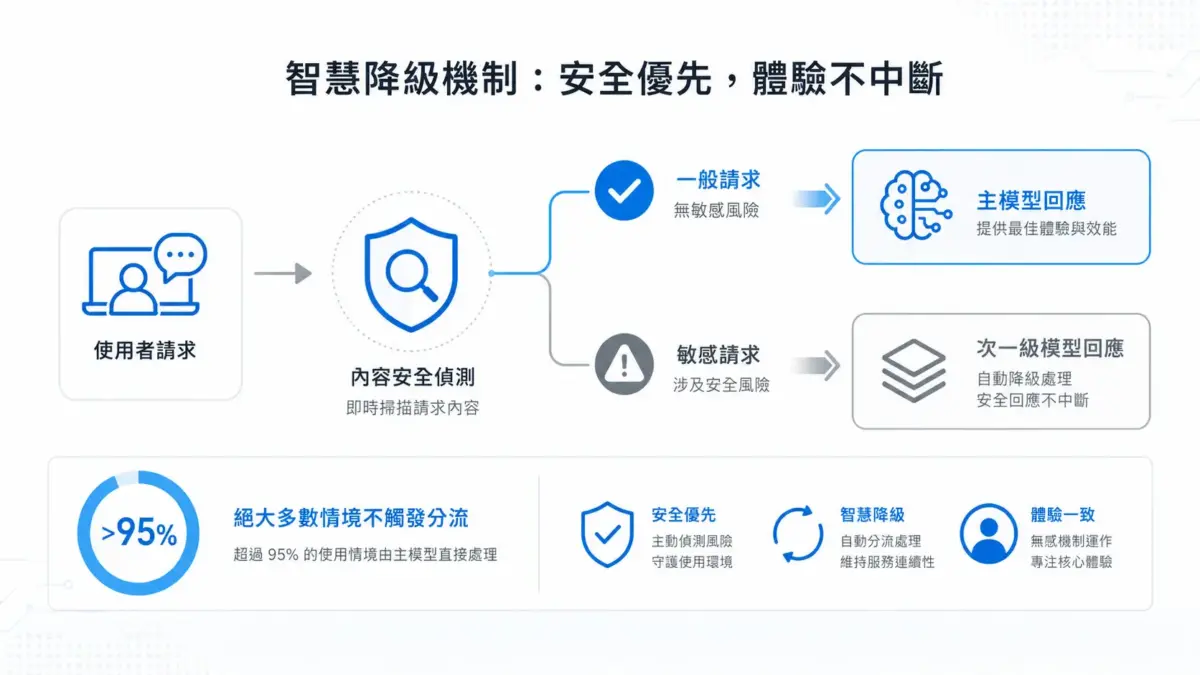
能力越強,Anthropic 把治理直接做進了產品裡。Fable 5 內建一組「分類器」:當偵測到與網路安全、生物化學或模型蒸餾相關的請求時,系統會自動改由次一級的 Claude Opus 4.8 來回應,而非直接拒絕,並會主動告知使用者。官方坦言這套防護目前刻意調得保守、寧可誤傷,因此偶爾會把無害的請求也擋下;但整體而言,超過 95% 的使用情境完全不會觸發分流。此外,Anthropic 也為這一級模型導入了 30 天資料保留政策,並言明不會用於訓練新模型、僅供安全防護用途。
把這件事放回更大的脈絡:當一項能力同時具備高度價值與高度風險(也就是所謂的「雙用途」。同一個查詢,在防禦者手上是助力,在攻擊者手上是威脅),治理就不再是事後補的稽核,而被前置成「能力本身的一部分」。這個設計取向,對任何正在盤點自身 AI 導入邊界的組織而言,都是一個可觀察、可對照的參考座標。
四、讀者最關心的:怎麼拿到、要多少錢?
這次發布另一個吸睛點是價格。Fable 5 與 Mythos 5 的定價為每百萬輸入 token 10 美元、每百萬輸出 token 50 美元,不到前一代 Mythos Preview 的一半。能力上升、價格反向下行,這個組合本身就會動到企業評估導入時的試算基礎。
上線與取得方式(依官方公告整理)
• Fable 5:即日起全面上線,開發者可透過 Claude API 以claude-fable-5取用。
• 訂閱方案分階段開放:6/9 至 6/22 期間,Pro、Max、Team 與席次制 Enterprise 方案免費包含;6/23 起改以「使用額度(usage credits)」計費;待產能充足後,官方表示會再把 Fable 5 恢復為訂閱方案的標準內容。
• Mythos 5:僅限 Glasswing 網路防禦夥伴(解除網路安全防護);另規劃面向少數生命科學研究者的「信任存取計畫」,後續才會逐步擴大。
對一般使用者而言,最直接的訊息是:現在(6/22 前)正是體驗這款頂級模型成本最低的視窗;對企業而言,則是能力與價格同時移動的這個時點,適合把先前因為「太貴」或「做不到」而擱置的場景,重新拿出來再評估一次。
結語:當「能跑多久」取代「答得多準」
把這次發布的幾條線索擺在一起。長流程自主性成為主打、跨領域能力同步站上前緣、價格腰斬、安全閥被做進產品。它們共同指向的,不是又一次跑分刷新,而是評估 AI 的尺規正在換軸:衡量的重點,正從「單題答得多準」,移向「能不能獨立、不間斷地扛完一段長流程」。
對企業而言,這個時點適合回頭做的,或許是重新盤點:哪些重複性高、過去因為「AI 撐不完整段」而只能切碎交付的長流程工作,其擱置的前提是否正在鬆動;以及,若要把這類長流程交付出去,對應的驗收標準與治理邊界,該長成什麼樣子。能力的座標軸移動時,最值得重新檢視的,往往不是工具本身,而是當初判斷「這件事 AI 還做不到」時所依據的那些假設。

如有任何問題或需求,請填寫以下表單,我們將竭誠為您解答!
您也可以透過以下按鈕了解更多資源: